Cómo arreglar subtítulos en vietnamita con letras raras
Actualizado el 31 de octubre de 2026
Descargas subtítulos en vietnamita, empiezas la película y ves líneas como Xin chà o, Chµo b¹n o Chaøo baïn. Los vietnamitas lo llaman “error de fuente” (lỗi font), pero la fuente casi nunca es el problema. El archivo se guardó con una codificación de texto, la tabla que convierte letras en bytes, y el reproductor lo lee con otra.
Cada tipo de error deja su propio rastro de símbolos. Con mirar unos pocos sabes en qué codificación está el archivo, y la solución casi siempre es la misma: leer el archivo con la codificación correcta y guardarlo en UTF-8, que leen todos los reproductores, teles y sitios web modernos.
Lee los símbolos para encontrar la causa
Toma la línea “Xin chào, bạn khỏe không?” (“Hola, ¿cómo estás?”). Según cómo se guardó el archivo y cómo lo lee el reproductor, puede convertirse en cualquiera de las siguientes.
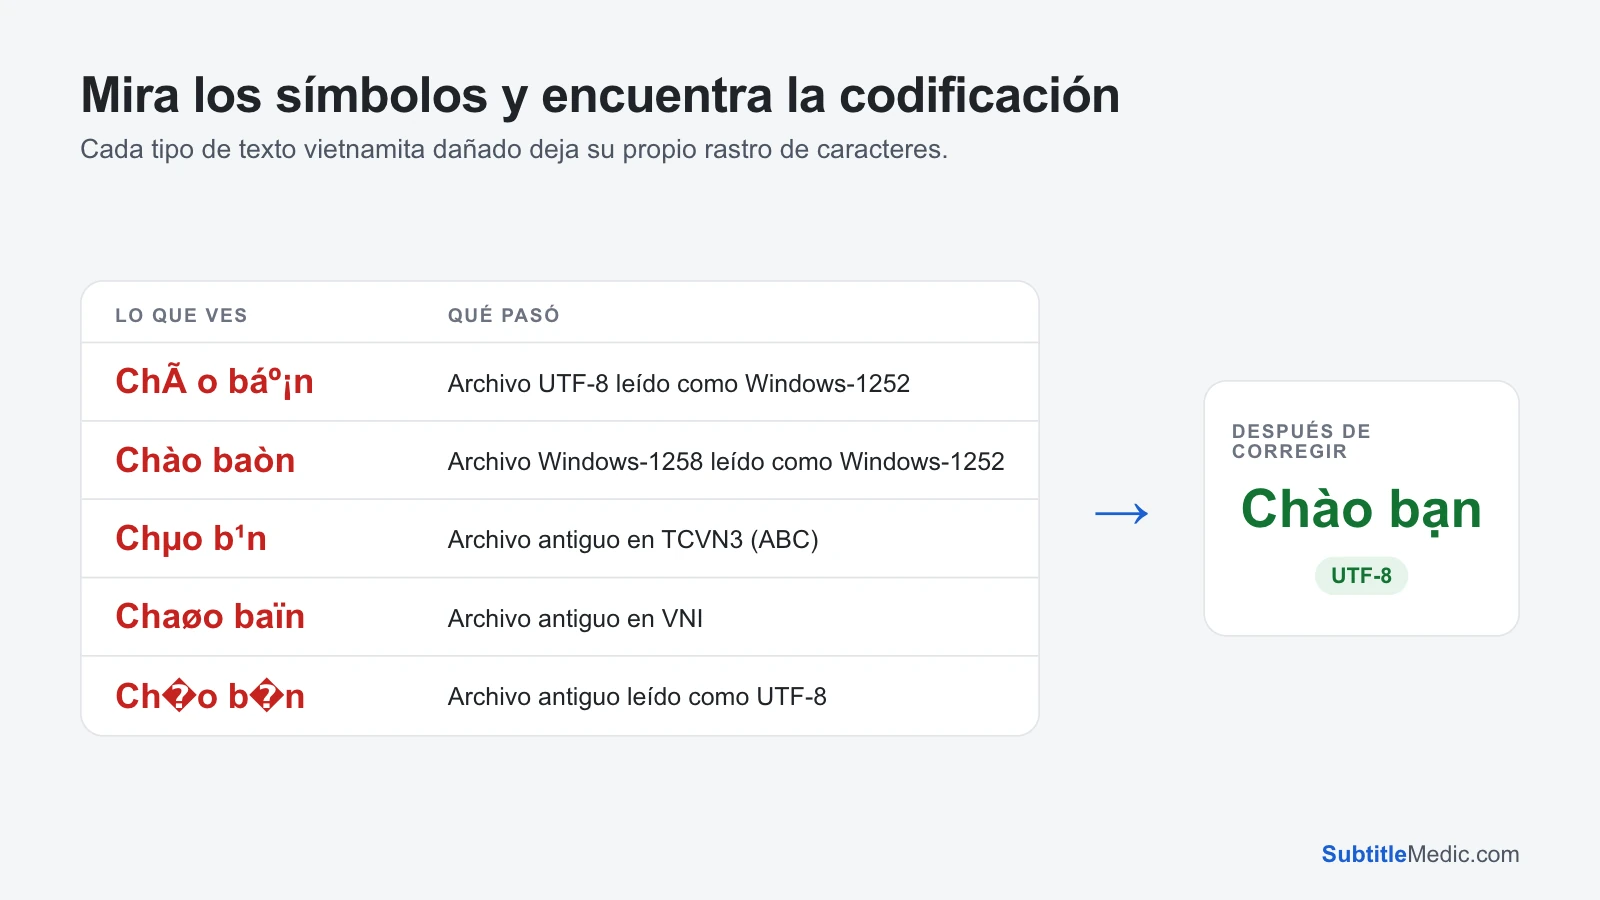 Abrir en tamaño completo (pestaña nueva)
“Xin chà o, bạn khá»e”: UTF-8 leído de la forma equivocada
Cada letra con marcas se vuelve dos o tres caracteres que empiezan con Ã, Ä, Æ o á»: đ se vuelve Ä‘, ố se vuelve ố, ư se vuelve Æ°. Es el mismo fallo que convierte «mañana» en «mañana» en un subtítulo en español.
Hay dos posibilidades:
- El archivo está bien; el reproductor lo lee mal. Es UTF-8, pero el reproductor (muchas veces una tele antigua, o un programa configurado con una codificación de Europa occidental) lo lee como Windows-1252.
- El archivo se dañó antes de que te llegara. Alguien abrió un archivo UTF-8 en un editor que supuso Windows-1252 y lo volvió a guardar en UTF-8. La basura ahora es parte del archivo y todos los reproductores la muestran.
Los dos casos tienen arreglo. En el segundo, la herramienta encuentra cada línea que se convirtió dos veces y devuelve las letras a su forma.
“Chµo b¹n, ®îc kh«ng?”: las fuentes TCVN3 (ABC)
Símbolos como µ, ¹, ®, «, ¬, Ö y Õ dentro de las palabras son la marca de TCVN3, también llamado ABC, la codificación de las fuentes .VnTime y .VnArial. Fue el estándar nacional de Vietnam desde 1993 y es común en subtítulos antiguos, documentos de Word y sitios web de principios de los 2000.
Algunos pares para reconocerlo: µ es à, ¹ es ạ, ® es đ, « es ô, ¬ es ơ, y un guion suave, normalmente invisible, es ư. Por eso “được” se ve como ®îc y parece tener solo tres caracteres.
TCVN3 no tiene códigos para las mayúsculas con marcas de tono: las mayúsculas se dibujaban con una fuente aparte (.VnTimeH). Al convertirlas a Unicode, esas letras salen en minúscula, así que “Ở” puede verse como “ở”.
“Chaøo baïn, ñöôïc khoâng?”: las fuentes VNI
Si las letras todavía se leen pero detrás de las vocales aparece un carácter raro (ø, ù, û, õ, ï, â, ä) y la đ se vuelve ñ, el archivo es VNI-Windows, la codificación de las fuentes VNI-Times y VNI-Helve. VNI escribe cada vocal con marcas en dos bytes: la vocal sola y luego sus marcas.
Algunos pares para reconocerlo: aø es à, aï es ạ, eä es ệ, oâ es ô, ô sola es ơ, ö es ư, ñ es đ. Por eso “Việt Nam” se ve como Vieät Nam y “được” como ñöôïc.
“Xin chào, baòn khoÒe”: Windows-1258 leído como Windows-1252
La mayoría de las letras están bien y solo algunas marcas de tono se descolocan: bạn se vuelve baòn, khỏe se vuelve khoÒe. Es Windows-1258, la página de códigos vietnamita de Microsoft. Guarda las marcas de tono como bytes aparte detrás de la vocal, y leídos como Windows-1252 esos bytes se convierten en otras letras.
“Xin ch?o, b?n kh?e” o “Xin ch�o”: un archivo antiguo leído como UTF-8
Signos de interrogación o un rombo con un signo de interrogación (�) en lugar de las letras con marcas significan que el reproductor lee el archivo como UTF-8 cuando en realidad está en una codificación más antigua (Windows-1258, TCVN3 o VNI). Los bytes de esas letras no son UTF-8 válido, así que se reemplazan.
Cuadros vacíos □□: falta una fuente, no es un problema de codificación
Si un editor de texto muestra bien las letras pero el reproductor muestra cuadros, el archivo está bien. La fuente de subtítulos del reproductor simplemente no tiene las formas de las letras vietnamitas. Cambia la fuente de subtítulos a Arial, Tahoma o Roboto, o en una tele busca una opción de idioma de subtítulos o de juego de caracteres y elige vietnamita.
Arréglalo en un paso
- Abre Corregir codificación de subtítulos y suelta el archivo
.srt,.vtt,.ass,.sbvo.sub. Se lee en tu navegador y nunca se sube. - La herramienta prueba todas las codificaciones que conoce, incluidas Windows-1258, TCVN3 y VNI, y elige la que da más vietnamita válido. Las letras con marcas se resaltan en la vista previa para que las revises.
- Si no está segura, muestra varias lecturas lado a lado. Elige aquella cuyas palabras se lean bien; no necesitas saber el nombre de la codificación.
- Descarga el archivo. Conserva su nombre y su formato y ahora está en UTF-8. Ponlo junto al video en lugar del viejo.
Los tiempos, los saltos de línea y el formato como la cursiva quedan exactamente como estaban. Solo cambia la forma en que se guardan las letras.
¿Lo guardaste en UTF-8 y la TV sigue mostrándolo mal?
Algunas teles y cajas multimedia antiguas solo reconocen UTF-8 cuando el archivo empieza con una marca de orden de bytes (BOM). En la herramienta, marca Agregar un BOM para televisores y reproductores antiguos y descarga otra vez. Si la tele no muestra ningún subtítulo, Por qué la tele no muestra los subtítulos repasa las otras causas, como el nombre y el formato del archivo.
Si las letras están bien pero en pantalla aparecen códigos como <font color=...> o {\an8}, quítalos con Quitar el formato de los subtítulos. Y si las palabras están bien pero aparecen demasiado pronto o demasiado tarde, usa Adelantar o atrasar subtítulos.
Por qué el vietnamita tiene tantas codificaciones
Hasta que Unicode se extendió a mediados de los 2000, las computadoras usaban codificaciones de un byte con lugar para 256 caracteres. El vietnamita necesita unas 134 letras con marcas, más que el espacio que queda después del latín básico. Cada grupo lo resolvió a su manera: TCVN3 dejó fuera las mayúsculas con marcas de tono, VNI separó las marcas en bytes propios, Windows-1258 usó marcas combinables y VISCII incluso ocupó las posiciones de los caracteres de control. Un archivo de subtítulos solo se leía bien en una computadora con las fuentes correspondientes instaladas.
UTF-8 lo resuelve: cada letra vietnamita, mayúsculas incluidas, tiene su propio código, y todos los dispositivos modernos lo leen. Por eso la herramienta siempre guarda en UTF-8.
La misma solución, paso a paso para tu reproductor: Kodi, Jellyfin, MX Player, PotPlayer, MPC-HC y smart TV.
Todas las herramientas de SubtitleMedic funcionan en tu navegador. Tu archivo de subtítulos se lee en tu dispositivo y nunca se sube.